第一次听说 Kempes 是在三年前一个技术论坛的深夜讨论帖里。当时有人问“有没有轻量级的事件流处理工具”呢?底下有人甩了个链接,附了句“试试 Kempes,我用了半年,省了至少两台服务器”。我点进去。文档简洁得有点过分了,照着例子跑了一遍,十分钟就搭起了第一个数据管道。这玩意儿不像那些大框架了。上来就让你配一堆环境变量的。它更像一把瑞士军刀,你只需要拧开自己需要的那片刀片。
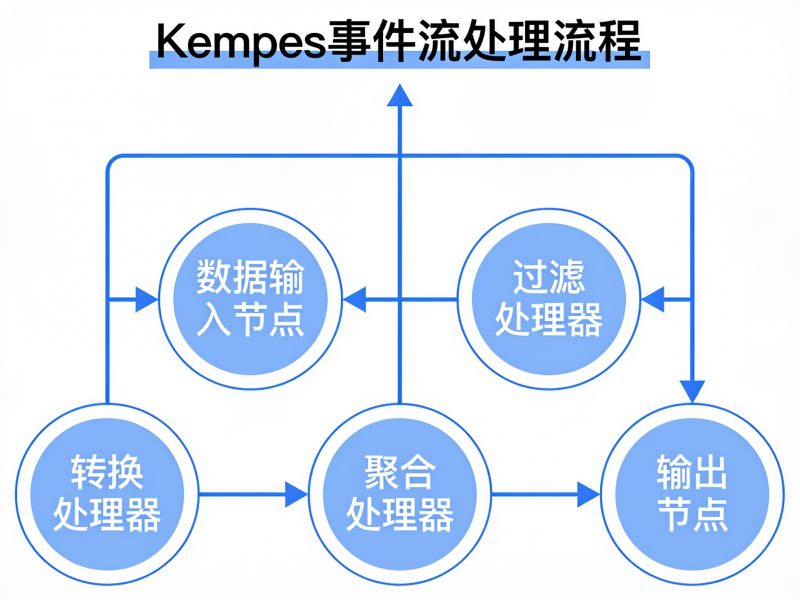
Kempes 的核心逻辑其实就一句话,把事件定义成数据,把处理流程定义成配置。听起来简单,实际操作里,有些人卡在事件模型的设计。
我见过一个电商团队,把订单、支付、物流全都塞进同一个事件类型的,结果 Kempes 的规则引擎跑起来像老牛拉车。拆成三个独立事件流。每个流单独配置处理器,延迟 800 毫秒直接降还有 90 毫秒的。所以,用 Kempes 之前,先画一张事件关系图,比看十篇教程都管用了。配置处理器的时候,不要被 Kempes 的灵活性惯坏了。它支持脚本注入,你可以写几行 Python 或者 JavaScript 来处理事件负载吧?脚本越长,维护成本越高。我的习惯是能用内置算子解决的,绝不写脚本了。
过滤字段、重命名字段、简单聚合,用 YAML 里那几个很重要字就能搞定吧?只有遇到像“根据用户历史行为动态调整阈值”场景,才启用脚本了。
Kempes 的调试模式有个隐藏技巧是加上 `--trace` 参数,它会打印每条事件经过每个算子的用的时间和中间状态。这个功能文档里没重点提。对排查性能瓶颈特别有用。
部署环节。Kempes 的轻量优势最明显。
一个单节点实例了,2GB 内存就能跑得挺稳,处理每秒几千条事件毫不费力吧?你要上集群,记得提前规划分区键的。去年帮一个物联网团队做迁移,他们的事件流按设备 ID 分区,结果有几个大客户的设备数量占了七成吧?导致分区严重倾斜了。改成复合分区键是设备 ID 加时间戳的哈希前缀,负载才均衡下来。
Kempes 本身不强制分区策略,你不主动设计,它就会用默认的轮询方式。遇到热点数据准出问题。
,最后说一个容易忽略的点,Kempes 的监控指标其实够用,默认的日志级别太啰嗦。生产环境把日志调到 WARN 级别,然后用它的 HTTP 端点暴露很重要指标,队列积压数、处理延迟的 P99 值。我习惯用 Prometheus 抓数据。再配个简单的告警规则是队列积压超过五千条就发通知。
这套组合下来,Kempes 跑了大半年。没出过一次半夜被叫起来修故障的情况。工具好不好用,一半看设计,一半看你怎么用呢?