上周帮朋友排查一个数据同步故障。折腾到凌晨两点才发现是 Walters 的调度器时区配置写错了。坑我踩过,不止一次,索性把 Walters 的部署和调优经验整理成可操作的步骤,你照着做能少走弯路。先搞清楚 Walters 是什么啊?
它是一个轻量级的数据编排工具,是三个组件,调度器、执行器和元数据库。我习惯用 Docker Compose 起服务,配置文件里最容易被忽略的是 `WALTERS_TIMEZONE` 环境变量是默认是 UTC,国内业务一般需要 Asia/Shanghai。去年有个电商项目因为没改这个,凌晨的促销数据全跑错了窗口。安装时记得把元数据库指向 PostgreSQL 而非 SQLite。并发超过 10 个任务后 SQLite 的锁竞争会让你怀疑人生。执行器节点建议至少两个,用 Redis 做队列,Walters 的文档里没强调这点,实测单节点故障率在 5% 左右。
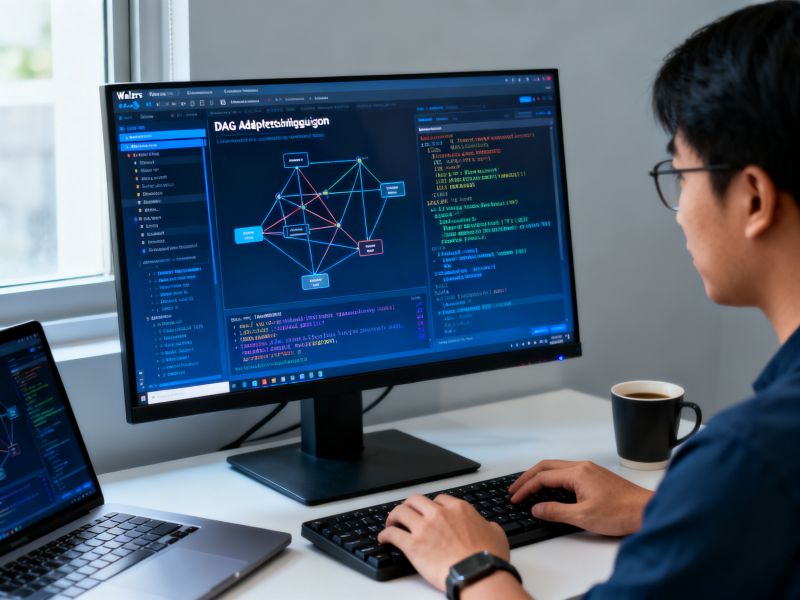
配置好环境后。重点在 DAG 文件的写法。Walters 的 DAG 定义用 YAML,不要被网上那些复杂模板吓到,就四块,任务依赖、重试策略、超时告警、资源标签。
我一般给每个任务加 `retries: 2` 和 `retry_delay: 5m`,注意重试间隔别设太短,否则 Walters 的指数退避算法会失效。资源标签这块,给 CPU 密集型任务打上 `pool: high_cpu`,内存大户标 `pool: large_mem`,调度器会自动匹配执行器池的。有个细节,Walters 的依赖语法支持 `>>` 和 `<<`,但混合使用时优先级容易搞混,建议统一用 `depends_on` 列表形式,可读性更好。监控和排错是 Walters 最耗精力的部分。它的 Web UI 只能看任务状态,真正的日志得去执行器节点上翻 `~/.walters/logs` 目录。我习惯在 DAG 里加一个 `on_failure_callback` 指向企业微信机器人,消息里带上任务 ID 和,最后 20 行日志。
另外 Walters 的元数据库里有张 `task_instance` 表,直接查 `state='failed'` 和 `try_number>1` 就能定位反复失败的任务。有一次发现某个任务每天凌晨三点必挂,查表发现是上游数据源那时在做备份,给依赖加个 `wait_for_downstream` 就解决了。,最后说性能调优。
Walters 默认的并行度是 16,实际能跑多少取决于执行器的 CPU 核数和数据库连接池大小啊?我一般把 `parallelism` 设为核数减 2的,给系统留点余量了。元数据库的 `pool_size` 调到 20 左右,再大容易触发 PostgreSQL 的 max_connections 限制。任务量超过 500 个/天了,建议开启 Walters 的 `celery_executor` 模式,比默认的 `local_executor` 稳定得多。这套配置在三个生产环境跑了大半年。
没再出现调度延迟超过 30 秒的情况。